ノンターゲットのメタボロミクスでは、1回の LC-MS 測定から数万の「特徴量(feature)」が返ってきます。この数字は、しばしば手法の到達点のように語られます。「2万以上の特徴量を検出した」と。
しかし特徴量は代謝物ではありません。 大腸菌の実データを系統的に注釈した研究は、25,230 の特徴量が、最終的に 892 のユニークな分析種にまで減ることを示しました。28 分の 1 です。
この落差を知らないまま数字を扱うと、報告も統計も設計もずれます。本記事では、まずその縮退の内訳を原著の数値で追い、縮退が統計の検出力をどう削るのかを計算で示します。そのうえで、メタボロミクスの品質を実際に支えているプールQCの置き方・受入基準・シグナル補正を、ガイドライン論文と 109 報の実態調査から整理します。
この記事の読み方:1〜4節は「返ってきた数字をどう読むか」で、入門の方にも読めるように書いています。5〜9節は現場の運用(QCの設計・受入基準・補正)で、数値と条文に踏み込みます。10節は同定の話に接続します。専門用語は初出時に短く補足します。
用語補足:特徴量(feature)は、ノンターゲット解析のソフトウェアが検出する「m/z と保持時間の組」ひとつを指す。ピーク1本に相当し、その化学的な正体が分かっているかどうかは問わない。
1. 25,230 が 892 になるまで
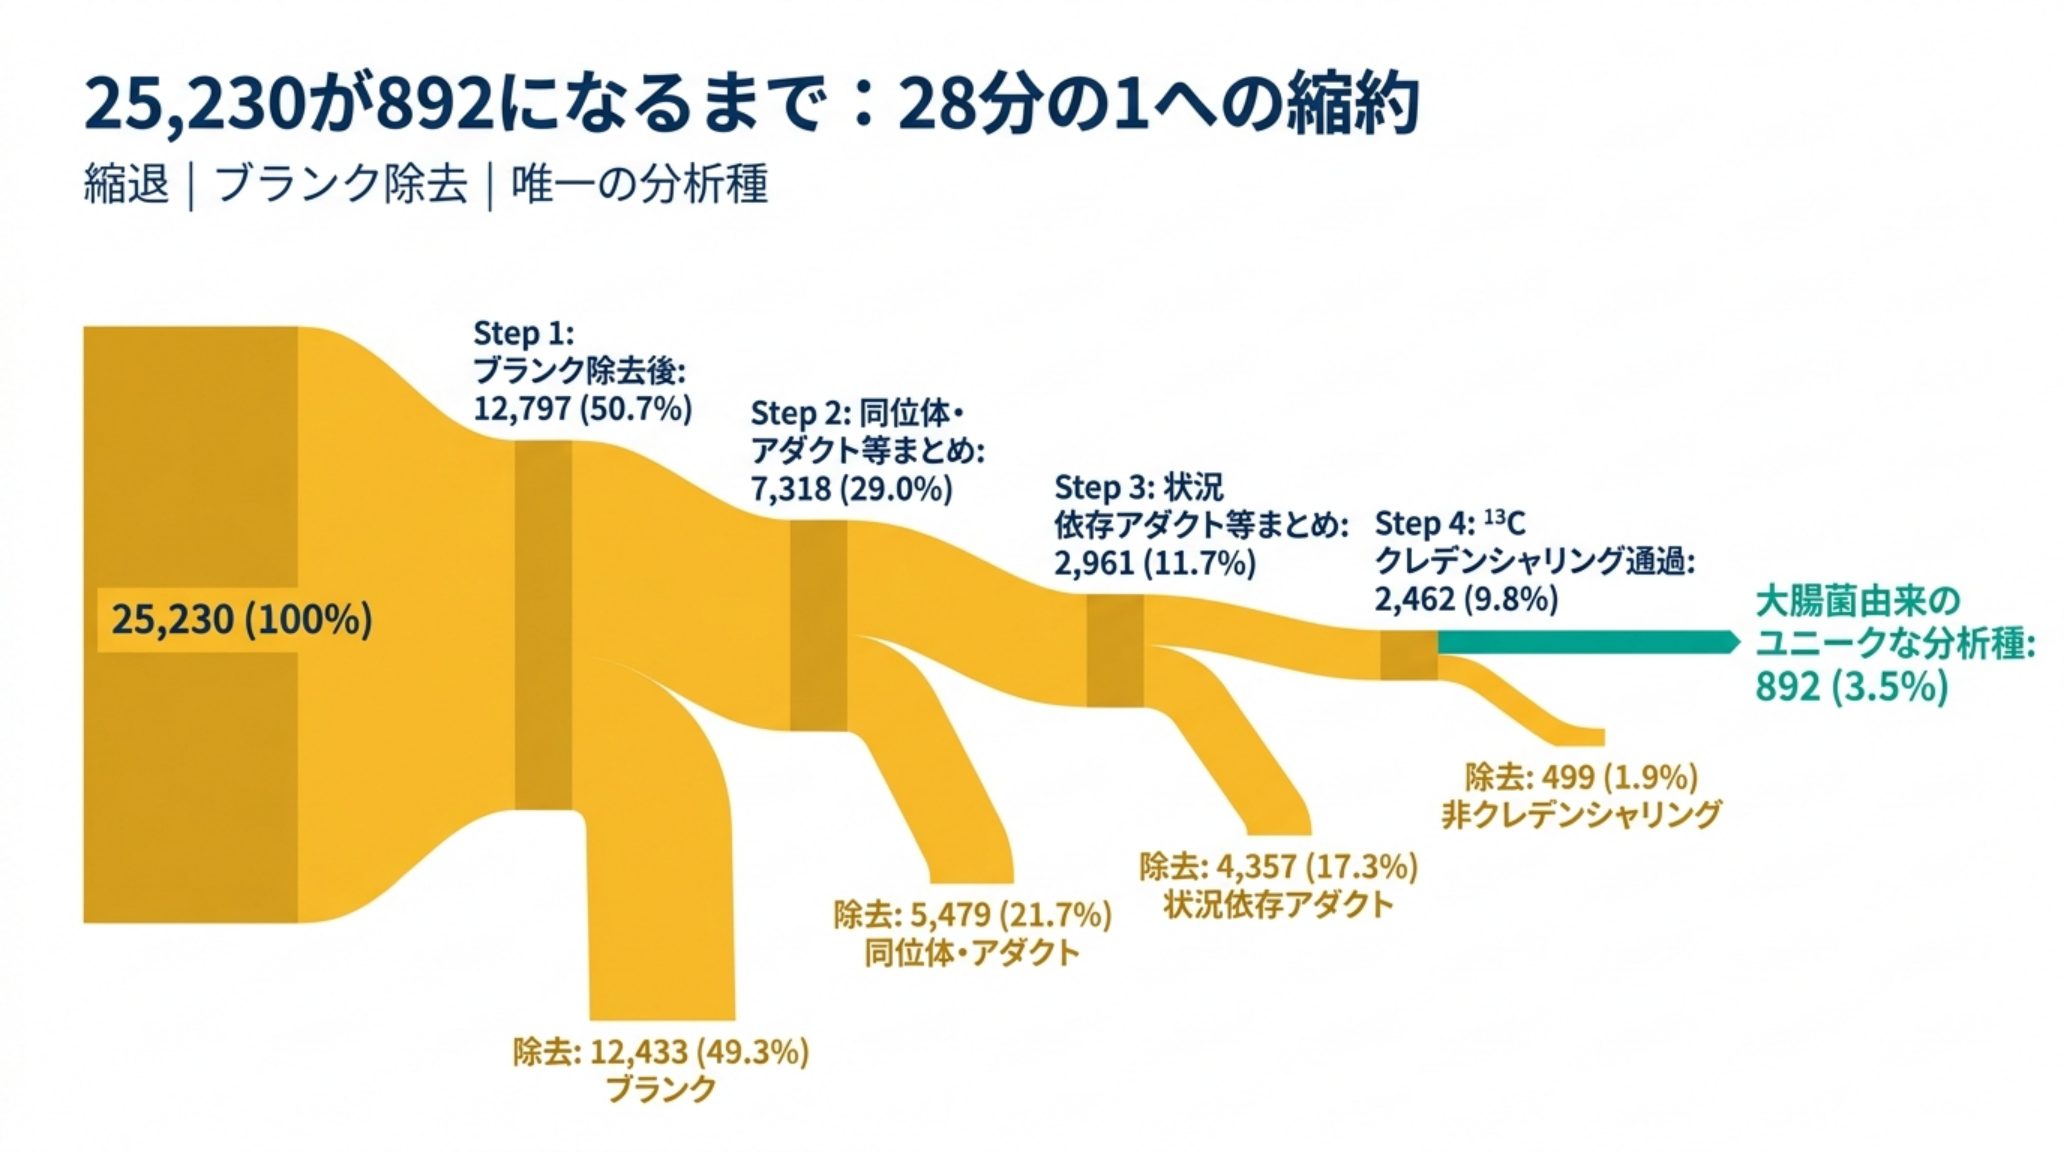
Mahieu と Patti が 2017 年に Analytical Chemistry に報告した研究は、大腸菌の抽出物を1つのノンターゲット法で測り、検出された特徴量を1つずつ由来で分類したものです。装置は逆相 UPLC(Waters Cortecs T3)+ Q Exactive Plus、ポジティブイオンモードです。
原著が報告した各段階の数字を並べます。
| 段階 | 特徴量/グループ数 | 最初の 25,230 に対して |
|---|---|---|
| 検出された高品質な特徴量 | 25,230 | 100 % |
| ブランク(溶媒・器具由来)を除いた残り | 12,797 | 50.7 % |
| 同位体・電荷キャリア・中性ロスをまとめた後 | 7,318 | 29.0 % |
| 多量体(複合アダクト)をまとめた後 | 3,400 | 13.5 % |
| 状況依存アダクトまでまとめた後 | 約 2,961 | 11.7 % |
| ¹³C 標識で大腸菌由来と確認できた特徴量 | 2,462 | 9.8 % |
| 大腸菌由来のユニークな分析種 | 892 | 3.5 % |
原著の表現は率直です。
驚くべきことに、この解析はこれまで報告されていなかった数千の縮退を明らかにし、ユニークな分析種の数を約 2,961 にまで減らした。
縮退の注釈により、測定されている大腸菌のユニークな分析種の推定数は 892 にまで減少した。
25,230 ÷ 892 = 28.3。 特徴量表の 1 行 1 行が別々の代謝物だと考えると、28 倍の数を数えていることになります。
規模の感覚をもう一つ。原著は、標的分析で調べられた例としてグルタミン酸 1 分子が 100 本を超えるスペクトルピークを生じたという報告を引いています。代謝物 1 つが特徴量 100 個になりうる――これが起点にある事実です。
2. なぜ 1 つの代謝物が何十もの特徴量になるのか
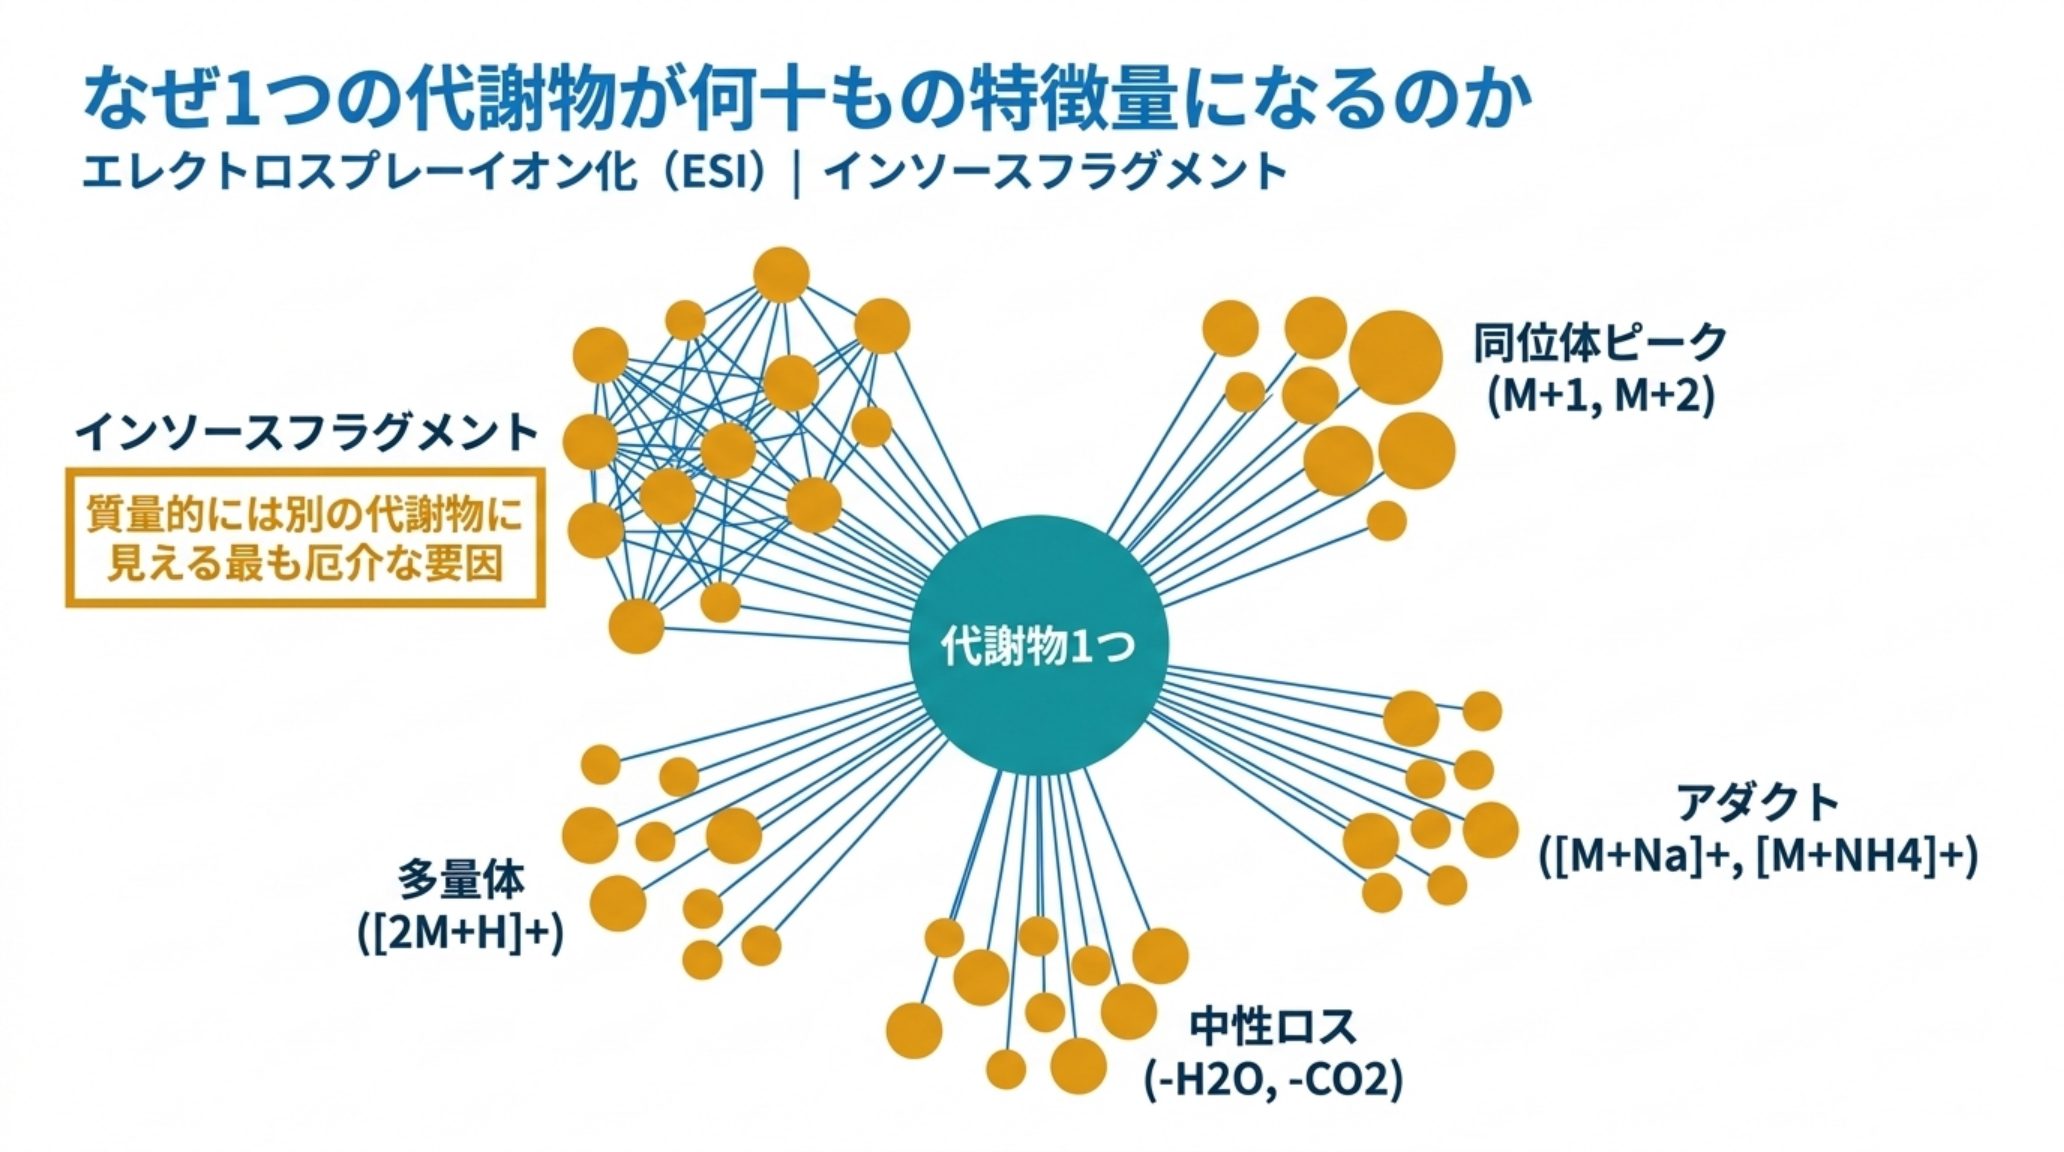
縮退(degeneracy)の正体は、エレクトロスプレーイオン化(ESI)が 1 つの分子から複数のイオンを作ることにあります。主な経路を、原著が段階的に取り除いた順に並べます。
(1)同位体ピーク ― 炭素の約 1.1 % は ¹³C なので、炭素数 n の分子には M+1、M+2 … の同位体ピークが必ず伴います。炭素数 20 の分子なら M+1 は M の約 22 % の強度で出ます。これだけで特徴量は 2〜3 倍になります。
(2)電荷キャリア(アダクト) ― 同じ分子が [M+H]⁺、[M+Na]⁺、[M+K]⁺、[M+NH₄]⁺ として別々の m/z に現れます。ナトリウムやカリウムは試料・溶媒・ガラス器具のどこからでも入ります。移動相に酢酸アンモニウムを使えば [M+NH₄]⁺ が加わります。
(3)中性ロス ― イオン源内で水(−18)やアンモニア(−17)、二酸化炭素(−44)などが外れたイオンが、独立した特徴量として検出されます。イオン源は「イオンを作る場所」であると同時に「壊す場所」でもあります。
(4)多量体(複合アダクト) ― 濃度が高い成分では [2M+H]⁺、[2M+Na]⁺ のような二量体が出ます。原著ではこの段階だけで 7,318 → 3,400 と半分以下になっています。多量体の寄与は想像より大きい、ということです。
(5)状況依存アダクト ― 特定のクロマトグラフィー条件・共溶出成分の組み合わせでのみ現れる付加体。再現性が低く、汎用の注釈ルールで拾いきれない部分です。
(6)インソースフラグメント ― 分子がイオン源内で開裂した断片。質量的には「別の代謝物」に見えるため、最も厄介な縮退です。グルタミン酸が 100 本のピークを生むのはこの寄与が大きいと考えられます。
ここで押さえるべきは、これらがすべて「正常な測定」の結果だという点です。装置の不調でも前処理の失敗でもありません。ESI と高分解能 MS を使う以上、縮退は原理的に発生します。問題は縮退が起きることではなく、それを数えたまま報告し、統計にかけてしまうことです。
3. 半分は、そもそも試料に由来していない
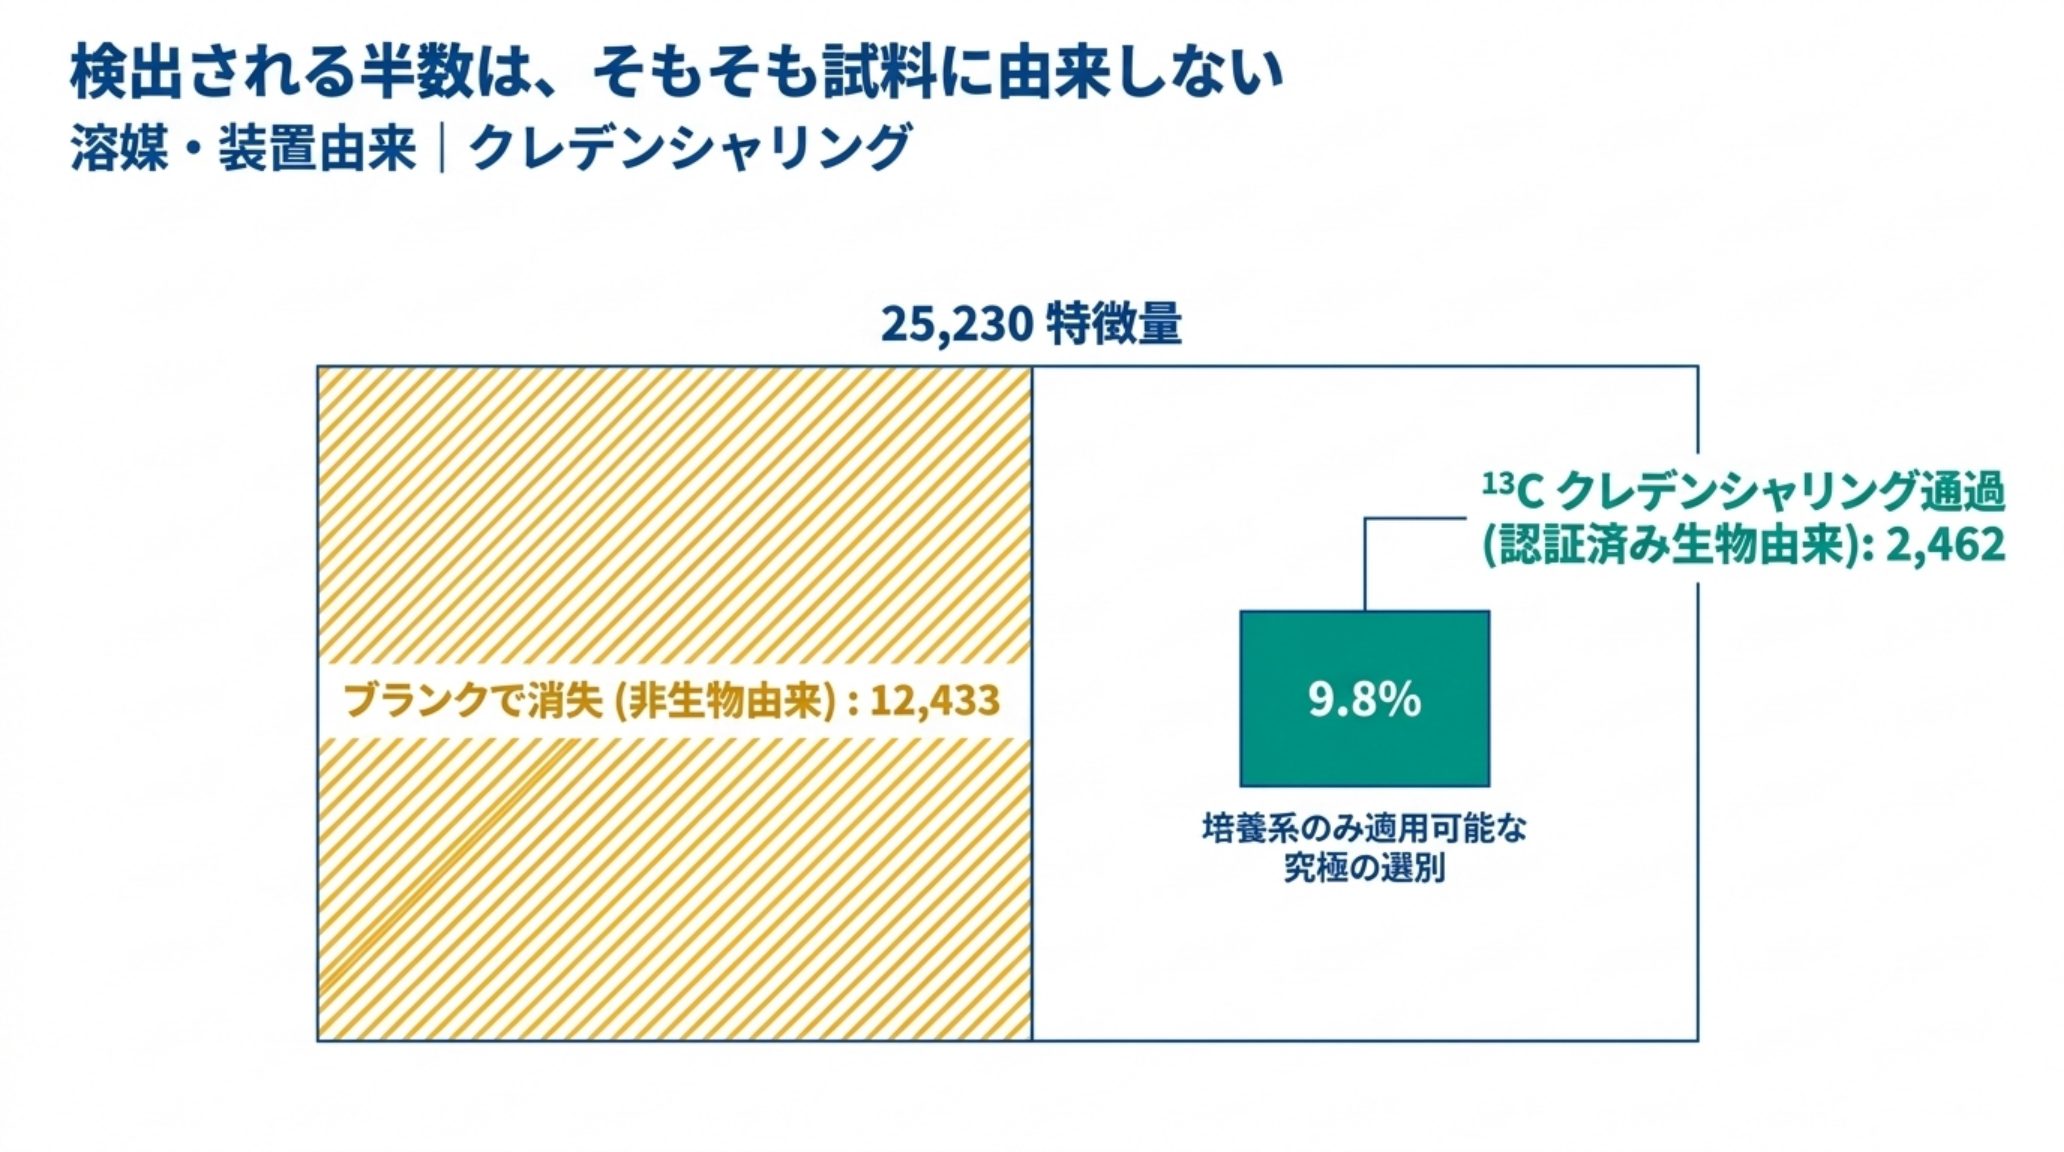
縮退と並ぶもう1つの事実が、特徴量の約半分が試料由来ですらないことです。
原著では、ブランク(試料を入れずに同じ工程を通したもの)と比較するだけで、25,230 が 12,797 に減っています。消えた 12,433 は全体の 49.3 %(筆者計算)。溶媒の不純物、チューブやフィルターからの溶出物、移動相の添加剤、装置由来のバックグラウンド――これらが特徴量表の半分を占めていたことになります。
さらに原著は credentialing(クレデンシャリング) という手法を使っています。大腸菌を ¹²C 培地と ¹³C 培地の両方で培養し、両者を混合すると、生物由来の分子だけが炭素数に応じた特徴的な同位体パターンを示す――この性質で「本当に菌が作った分子」を選別します。
このような同位体シグネチャーを示す特徴量は「credentialed(認証済み)」とみなされる。菌由来であることが分かっているからである。対照的に、このシグネチャーを示さない特徴量は、アーティファクトまたは汚染物として注釈される。
この選別を通ったのが 2,462 特徴量。最初の 25,230 に対して 9.8 % です。そして縮退をまとめると 892 の分析種になります。
「2万個の特徴量を検出した」という報告のうち、生物学的に意味のある単位は 1,000 に届かないことがある。 原著のタイトルが「25,000 の特徴量を 1,000 未満のユニークな代謝物に減らす」となっているのは、この結論そのものです。
用語補足:credentialing は、安定同位体標識した培養と非標識の培養を混ぜて測ることで、生物由来のシグナルとそれ以外を区別する手法。培養できる系(微生物・細胞)でしか使えない点が制約で、血漿や組織には直接適用できない。
4. 縮退は、統計の検出力をそのまま削る(筆者計算)
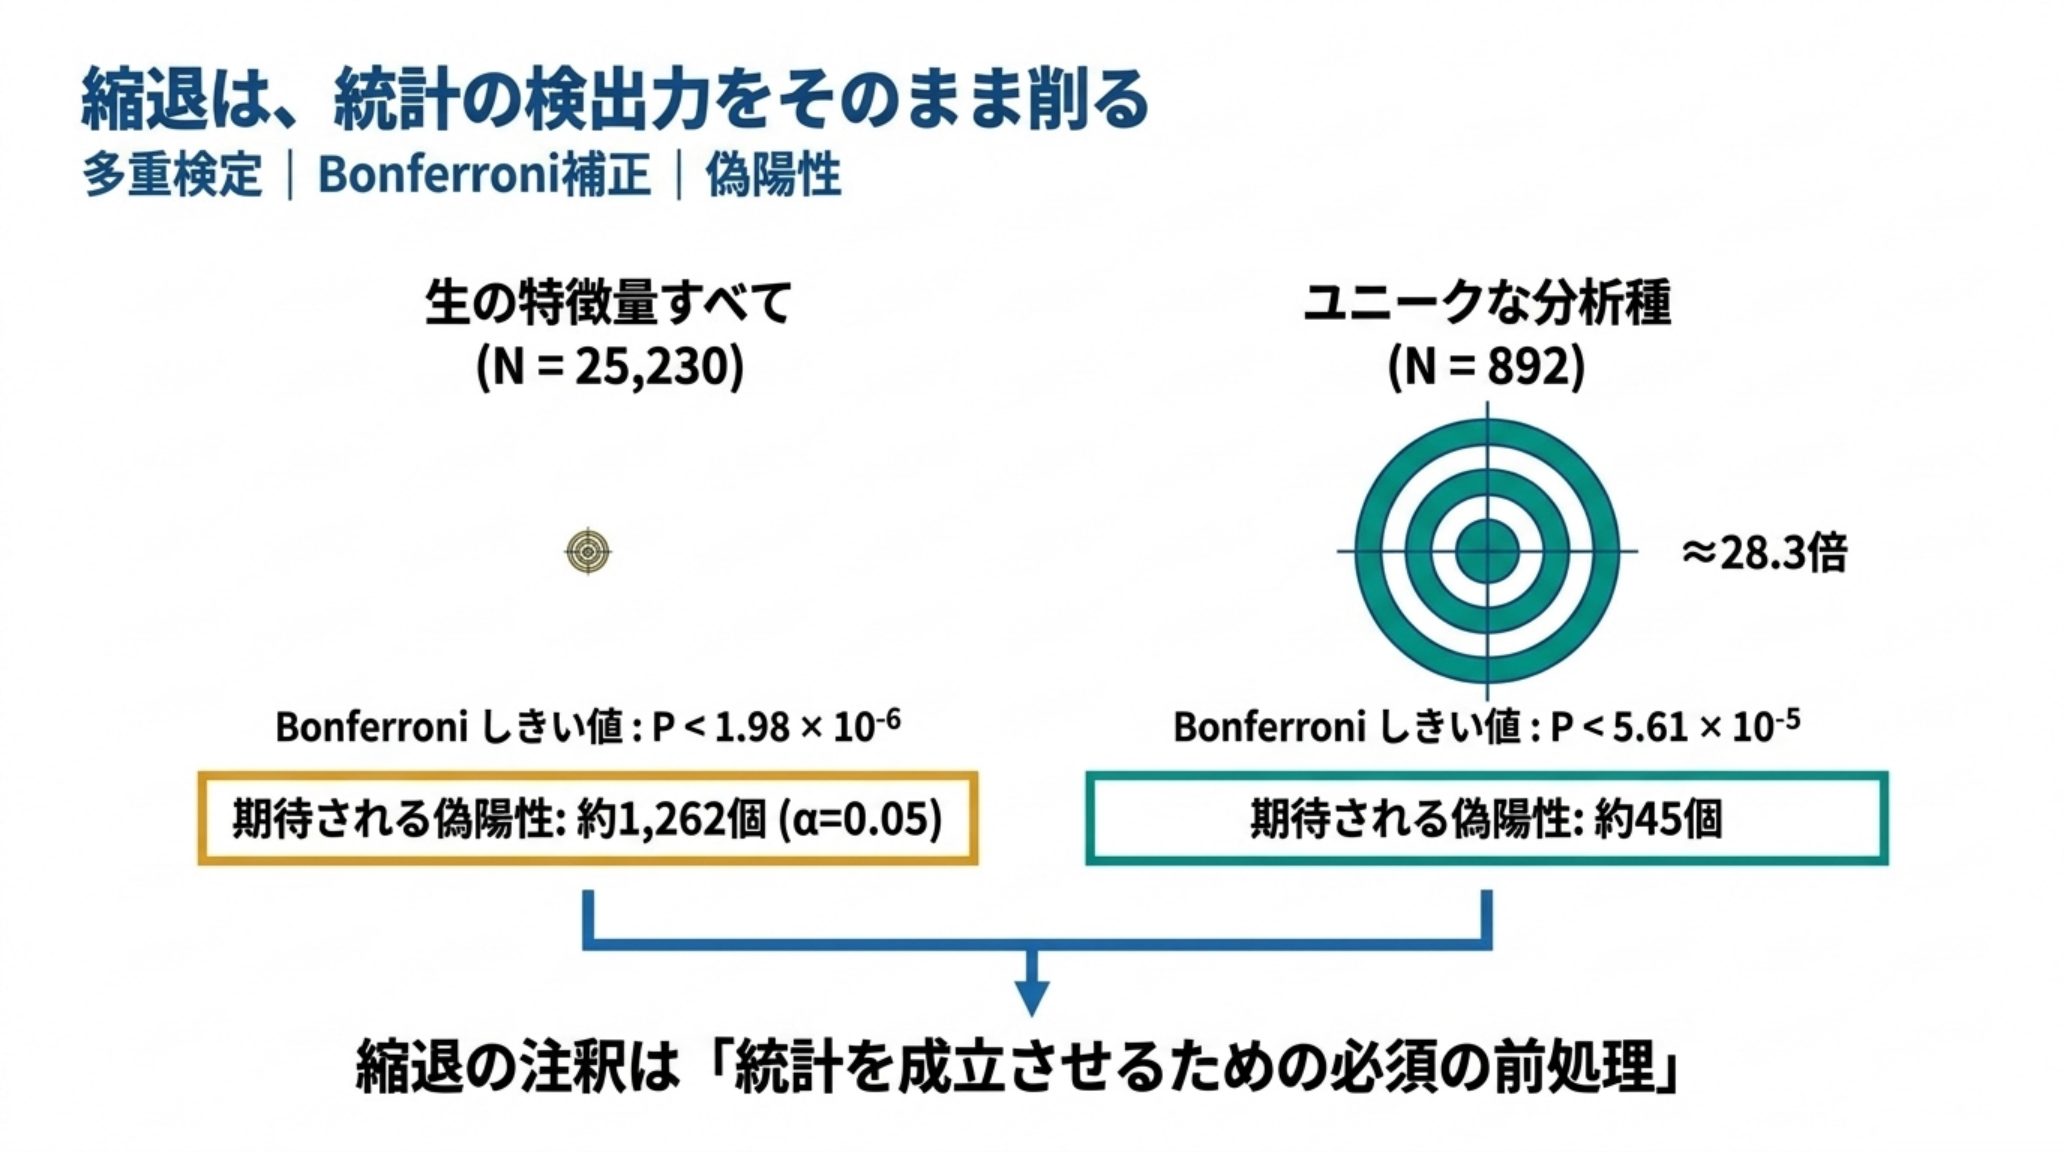
縮退を「報告上の見栄えの問題」と捉えると本質を外します。検定の数が変わるからです。
ノンターゲットのメタボロミクスでは、特徴量ごとに群間比較を行います。検定を N 回繰り返すので多重検定の補正が要ります。最も保守的な Bonferroni 補正では、有意水準 α を検定数 N で割った値をしきい値にします。
この N に何を入れるかで、しきい値は次のように変わります(α = 0.05、筆者計算)。
| 検定に使う数 | 意味 | Bonferroni のしきい値 |
|---|---|---|
| 25,230 | 生の特徴量すべて | 1.98 × 10⁻⁶ |
| 12,797 | ブランク除去後 | 3.91 × 10⁻⁶ |
| 2,961 | 縮退をまとめた後 | 1.69 × 10⁻⁵ |
| 892 | ユニークな分析種 | 5.61 × 10⁻⁵ |
生の特徴量で補正すると、ユニークな分析種で補正する場合より 28.3 倍厳しいしきい値を自分に課すことになります。 本来 p = 3 × 10⁻⁵ で検出できたはずの差が、有意でなくなる。縮退した特徴量は、情報を増やさずに検定の分母だけを増やしているのです。
逆方向の影響もあります。補正なしで有意水準 5 % をそのまま適用した場合、期待される偽陽性は 25,230 検定で約 1,262 個、892 検定で約 45 個(筆者計算)。「有意な特徴量が 1,000 個見つかった」という報告が、偽陽性の期待値とほぼ同じ規模だということが起こりえます。
さらに厄介なのは、縮退した特徴量どうしが強く相関していることです。同じ分子の [M+H]⁺ と [M+Na]⁺ は、当然ながら同じ挙動を示します。すると――
- 同じ発見が何度も「独立に」報告される。 上位 20 個の特徴量が、実は 3 つの代謝物だった、ということが起こります。
- 多変量解析(PCA・PLS-DA)で、特定の代謝物の寄与が水増しされる。 縮退の多い高濃度成分ほど、主成分を強く引っ張ります。
- FDR 補正(Benjamini-Hochberg)も、検定が独立という前提から外れます。
だから縮退の注釈は「きれいに見せるための後処理」ではなく、統計を成立させるための前処理です。 原著が「データセットの理解が不十分なことが解釈を複雑にし、実際に測定されているユニークな代謝物の数を覆い隠してきた」と書くのは、この意味においてです。
5. プールQC ― 1種類の試料が 3 つの役割を兼ねている
ここから運用の話に移ります。メタボロミクスの品質を実際に支えているのは、プールQC(pooled QC)です。研究に含まれる全検体から少量ずつ取って混ぜた、その研究の「平均的な試料」を作り、分析バッチの中に繰り返し挟み込みます。
Broadhurst らによる 2018 年のガイドライン論文(Metabolomics 14:72)は、品質管理に使う試料を役割ごとに分けています。
| 試料 | 役割 |
|---|---|
| システム適合性試料 | 試料分析の前に、装置が動作していること・汚染がないことを確認する |
| 同位体標識内標準 | 1検体ごとに、系の安定性(m/z・保持時間・ピーク面積・ピーク形状)を確認する |
| プールQC | ①装置のコンディショニング ②研究内再現性の測定 ③系統誤差の数学的補正 |
| 標準物質(SRM)・長期参照QC | 研究間・ラボ間の比較に使う |
注目すべきは、プールQC が 1 種類で 3 つの役割を兼ねていることです。装置を慣らし、精度を測り、ドリフトを補正する。役割が違えば必要な個数も置き場所も違うのに、同じ試料で兼ねるため設計が混乱しやすい。ここが実務の分かれ目になります。
内標準とプールQCの違いも押さえておきます。ガイドラインは内標準の利点をこう書いています。
プールQC のアプローチに対するこの内標準法の利点のひとつは、各検体についてのデータ収集と評価(m/z、保持時間、ピーク面積、ピーク形状)を、他の検体と独立に実行できることである。
つまり内標準は「その1本」の異常を検出でき、プールQCは「バッチ全体の傾向」を捉える。両方が要る、という整理になります。
6. どこに何個置くか ― ガイドラインの数値
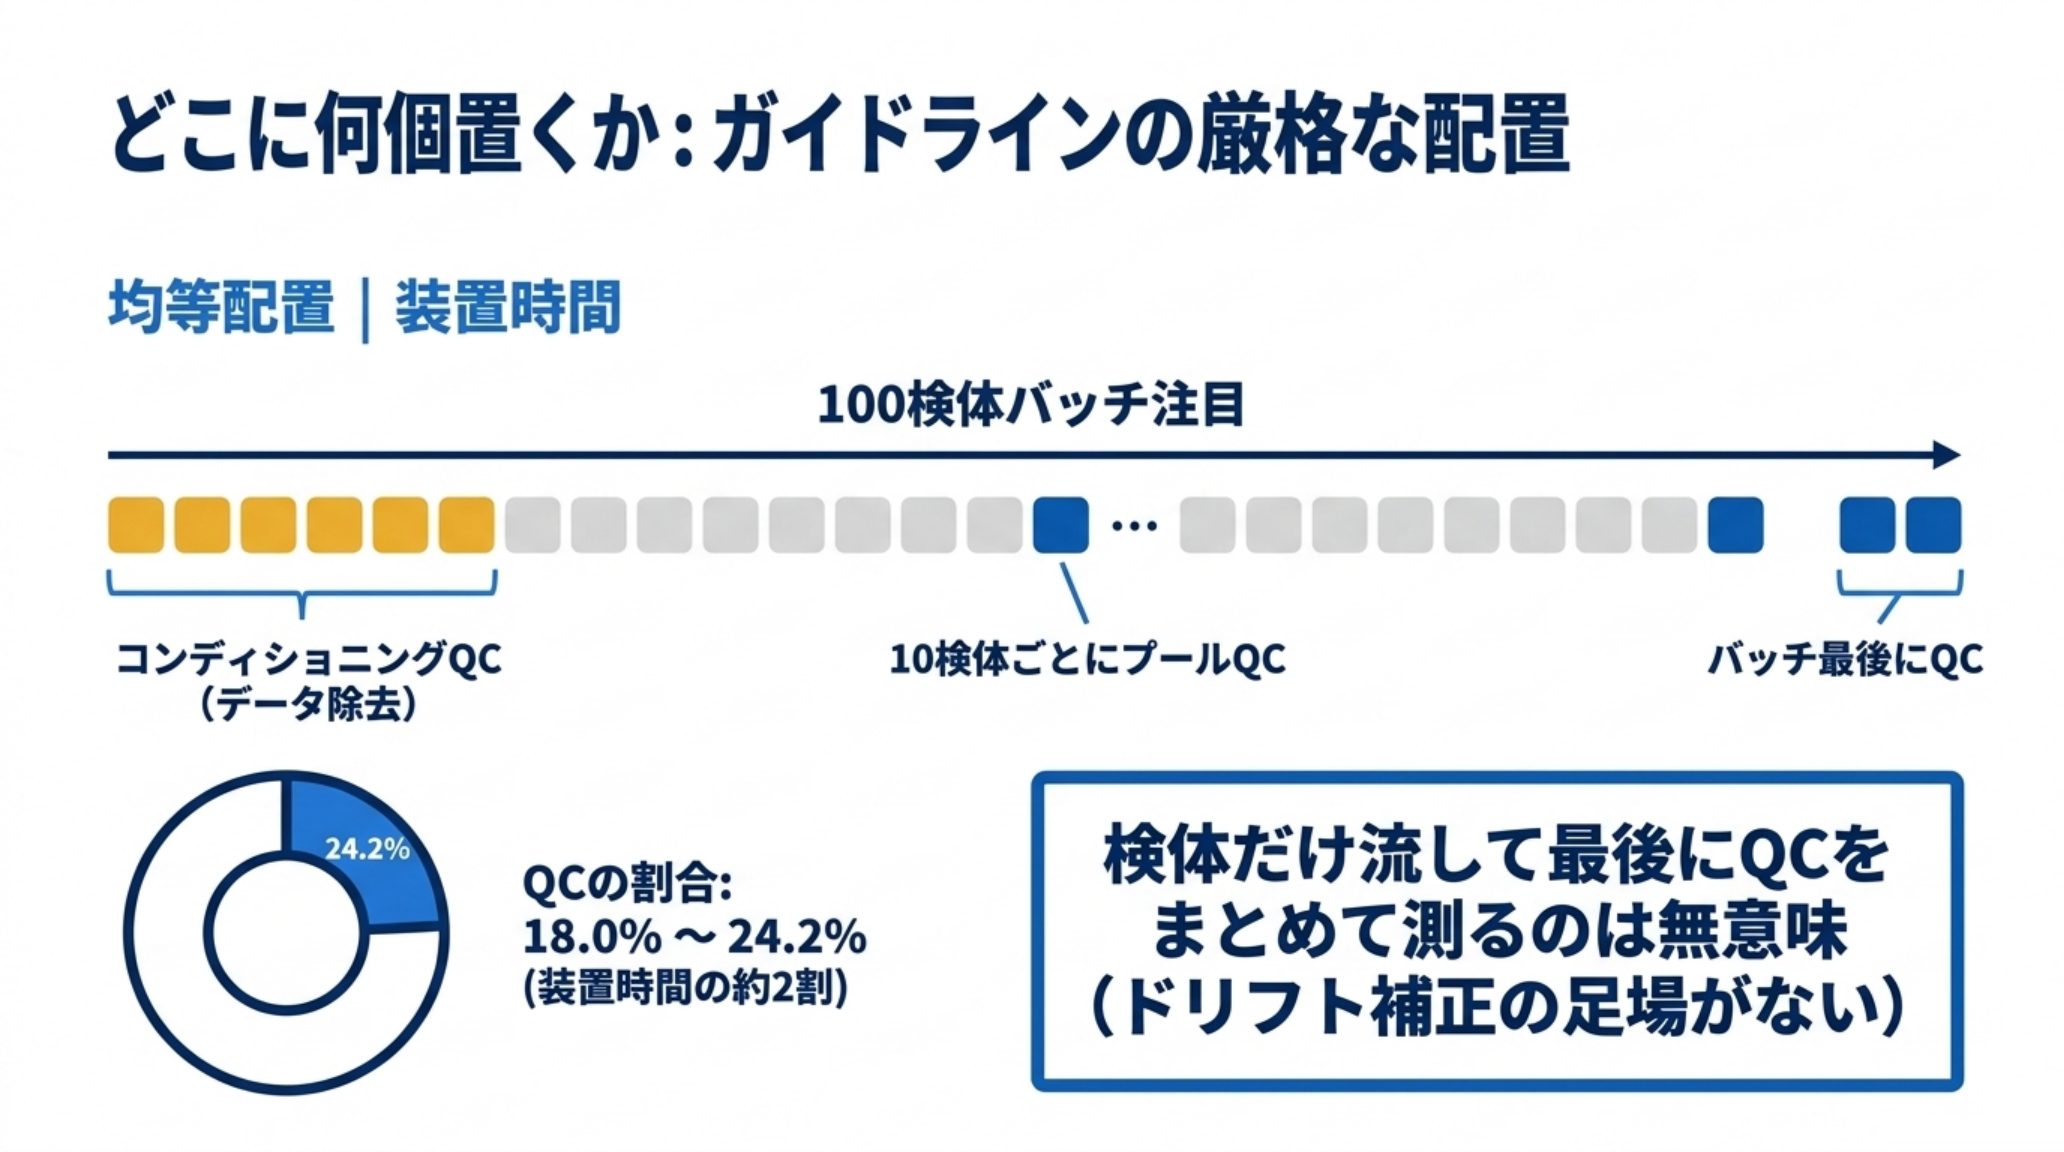
Broadhurst らの勧告は具体的です。逐語で引きます。
正確な QC 評価のためには、プールQC を少なくとも 10 検体ごとに1回分析すること、および/または、単一バッチ内に少なくとも 5 個のプールQC を均等に配置することが推奨される。非線形のシグナル補正アルゴリズムを用いる場合は、少なくとも 8 個のプールQC 試料を用いることが推奨される。さらに、QC の注入ミスに対する備えとして、バッチの最初と最後、つまり全ての試験試料の前後に 2 個ずつの QC 試料を分析することも推奨される。
コンディショニングについても数値があります。
ここでは、各バッチの開始時に 8 個のプールQC 試料を分析して装置をコンディショニングし、そのデータはデータ処理の前に除去する。
そして、コンディショニングに何本必要かの決め方まで書かれています。
各ラボは、50 個のプールQC 試料を注入し、安定したデータが取得され始める注入回数を定義することによって、それぞれの分析プラットフォームと試料タイプについて最適なコンディショニング QC 注入回数を決定すべきである。
「8 個」は出発点であって、自分の系で決め直す数字だということです。
これが分析時間に与える影響(筆者計算)
勧告どおりに組むと、QC は無視できない割合を占めます。100 検体の研究を 1 バッチで回す場合です。
| QC の頻度 | QC 注入数(定期+コンディショニング8+前後4) | 総注入数 | QC の割合 | 1 注入 15 分なら |
|---|---|---|---|---|
| 10 検体ごと | 10 + 8 + 4 = 22 | 122 | 18.0 % | バッチ 30.5 時間(うち QC 5.5 時間) |
| 5 検体ごと | 20 + 8 + 4 = 32 | 132 | 24.2 % | バッチ 33.0 時間(うち QC 8.0 時間) |
装置時間の 2 割前後を QC に使うのが、ガイドラインに沿った運用です。ここを削ると、後述する補正が成立しなくなります。「検体だけ流して QC は最後にまとめて数本」では、ドリフト補正の足場がありません。
なお、バッチ内の典型的な並びはガイドラインの図に示されています。システム適合性試料 → ブランク → プールQC 10 注入(コンディショニング 8 + QC/補正用 2)→ 試験試料(5〜10 検体ごとにプールQC を挟む。標準物質を 3 回、抽出ブランクを 2 回)→ プールQC 2 注入 → システム適合性試料、という形です。
7. 受入基準 ― RSD だけでは足りない理由
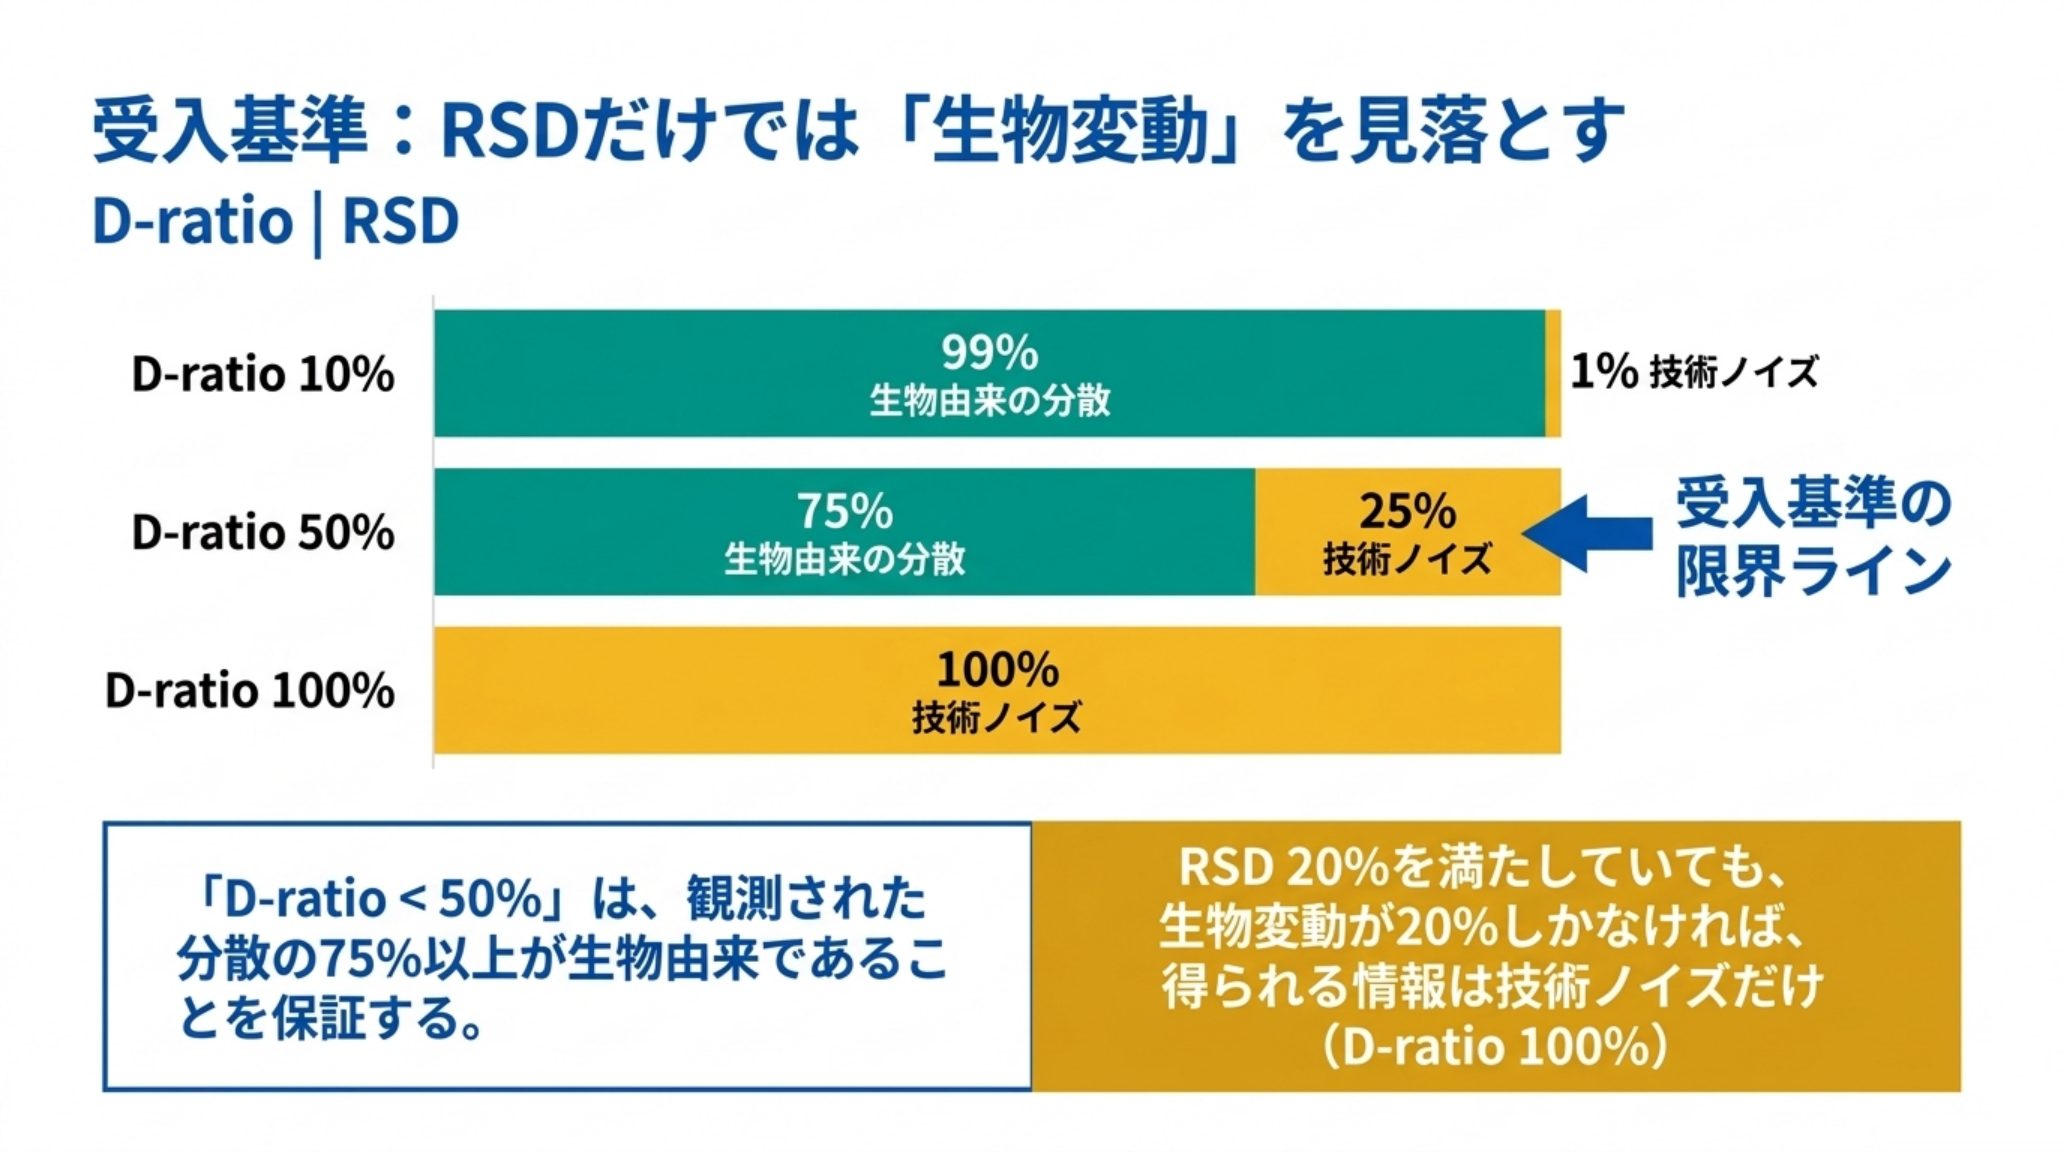
取得したデータから、どの特徴量を残しどれを捨てるか。ガイドラインは 3 つの指標を挙げています。
検出率の受入基準は典型的には > 70 % に設定され、RSD の受入基準は試料タイプに応じて典型的には < 20 %(Sangster ら 2006、Dunn ら 2011b)または < 30 %(Lewis ら 2016、Want ら 2010)に設定される。そして D-ratio の受入基準は、多くとも < 50 %(できればはるかに低く)に設定することが推奨される。
検出率は「その特徴量が全検体中の何 % で検出されたか」。RSD はプールQC における相対標準偏差で、技術的なばらつきの大きさです。分布が正規でない場合に備え、中央絶対偏差(MAD)を使った頑健版も定義されています。
RSD* = 1.4826 × MAD ÷ 中央値 × 100 %
(1.4826 は、MAD を標準偏差の不偏推定に変換する係数)
D-ratio ― 技術ノイズを生物変動と比べる
3 つ目の D-ratio(Dispersion ratio、分散比) が、この記事でいちばん実務に効く指標です。定義は単純です。
D-ratio = プールQC の標準偏差 ÷ 生物試料の標準偏差 × 100 %
ガイドラインは背景にある分散の分解も示しています。総分散 = 生物分散 + 技術分散、と置き、プールQC の分散を技術分散の近似、生物試料の分散を総分散の近似とみなす、という構造です。
ここから、D-ratio の値が「観測された分散のうち何 % が生物由来か」に直結します(筆者計算)。技術分散の割合は D-ratio の 2 乗になるので、生物由来の割合は 1 − D² です。
| D-ratio | 技術由来の分散 | 生物由来の分散 |
|---|---|---|
| 10 % | 1.0 % | 99.0 % |
| 20 % | 4.0 % | 96.0 % |
| 30 % | 9.0 % | 91.0 % |
| 50 % | 25.0 % | 75.0 % |
| 70 % | 49.0 % | 51.0 % |
| 100 % | 100 % | 0 % |
つまり「D-ratio < 50 %」という基準は、「観測された分散の 75 % 以上が生物由来であること」を要求しています。 そしてガイドラインが「できればはるかに低く」と付け加える理由も見えます。D-ratio 30 % なら生物由来は 91 %。この差は、群間比較の検出力にそのまま効きます。
RSD だけを見ていると何を見落とすか(筆者計算)
RSD と D-ratio は独立ではありません。同じ RSD でも、生物変動の大きさ次第で D-ratio はまったく違う値になります。
| プールQC の RSD | 生物試料の変動 | D-ratio | 生物由来の分散 | 判定 |
|---|---|---|---|---|
| 20 % | 20 % | 100 % | 0 % | RSD 基準は通るが、生物情報はゼロ |
| 20 % | 60 % | 33 % | 88.9 % | 良好 |
| 30 % | 40 % | 75 % | 43.8 % | RSD 30 % 基準は通るが、半分以上が技術ノイズ |
| 35 % | 200 % | 17.5 % | 96.9 % | RSD 基準では落ちるが、実際には非常に良い |
RSD 20 % を満たしていても、その代謝物の生物変動が 20 % しかなければ、得られるのは技術ノイズだけです。 逆に RSD 35 % で「不合格」にした特徴量が、生物変動 200 % の系では最も情報量の多い特徴量かもしれません。
RSD はしきい値としては扱いやすいが、それ単独では「使える特徴量か」を判定できない。 D-ratio がガイドラインに加えられた理由がここにあります。
8. シグナル補正 ― 「どれが最良か」は決まっていない
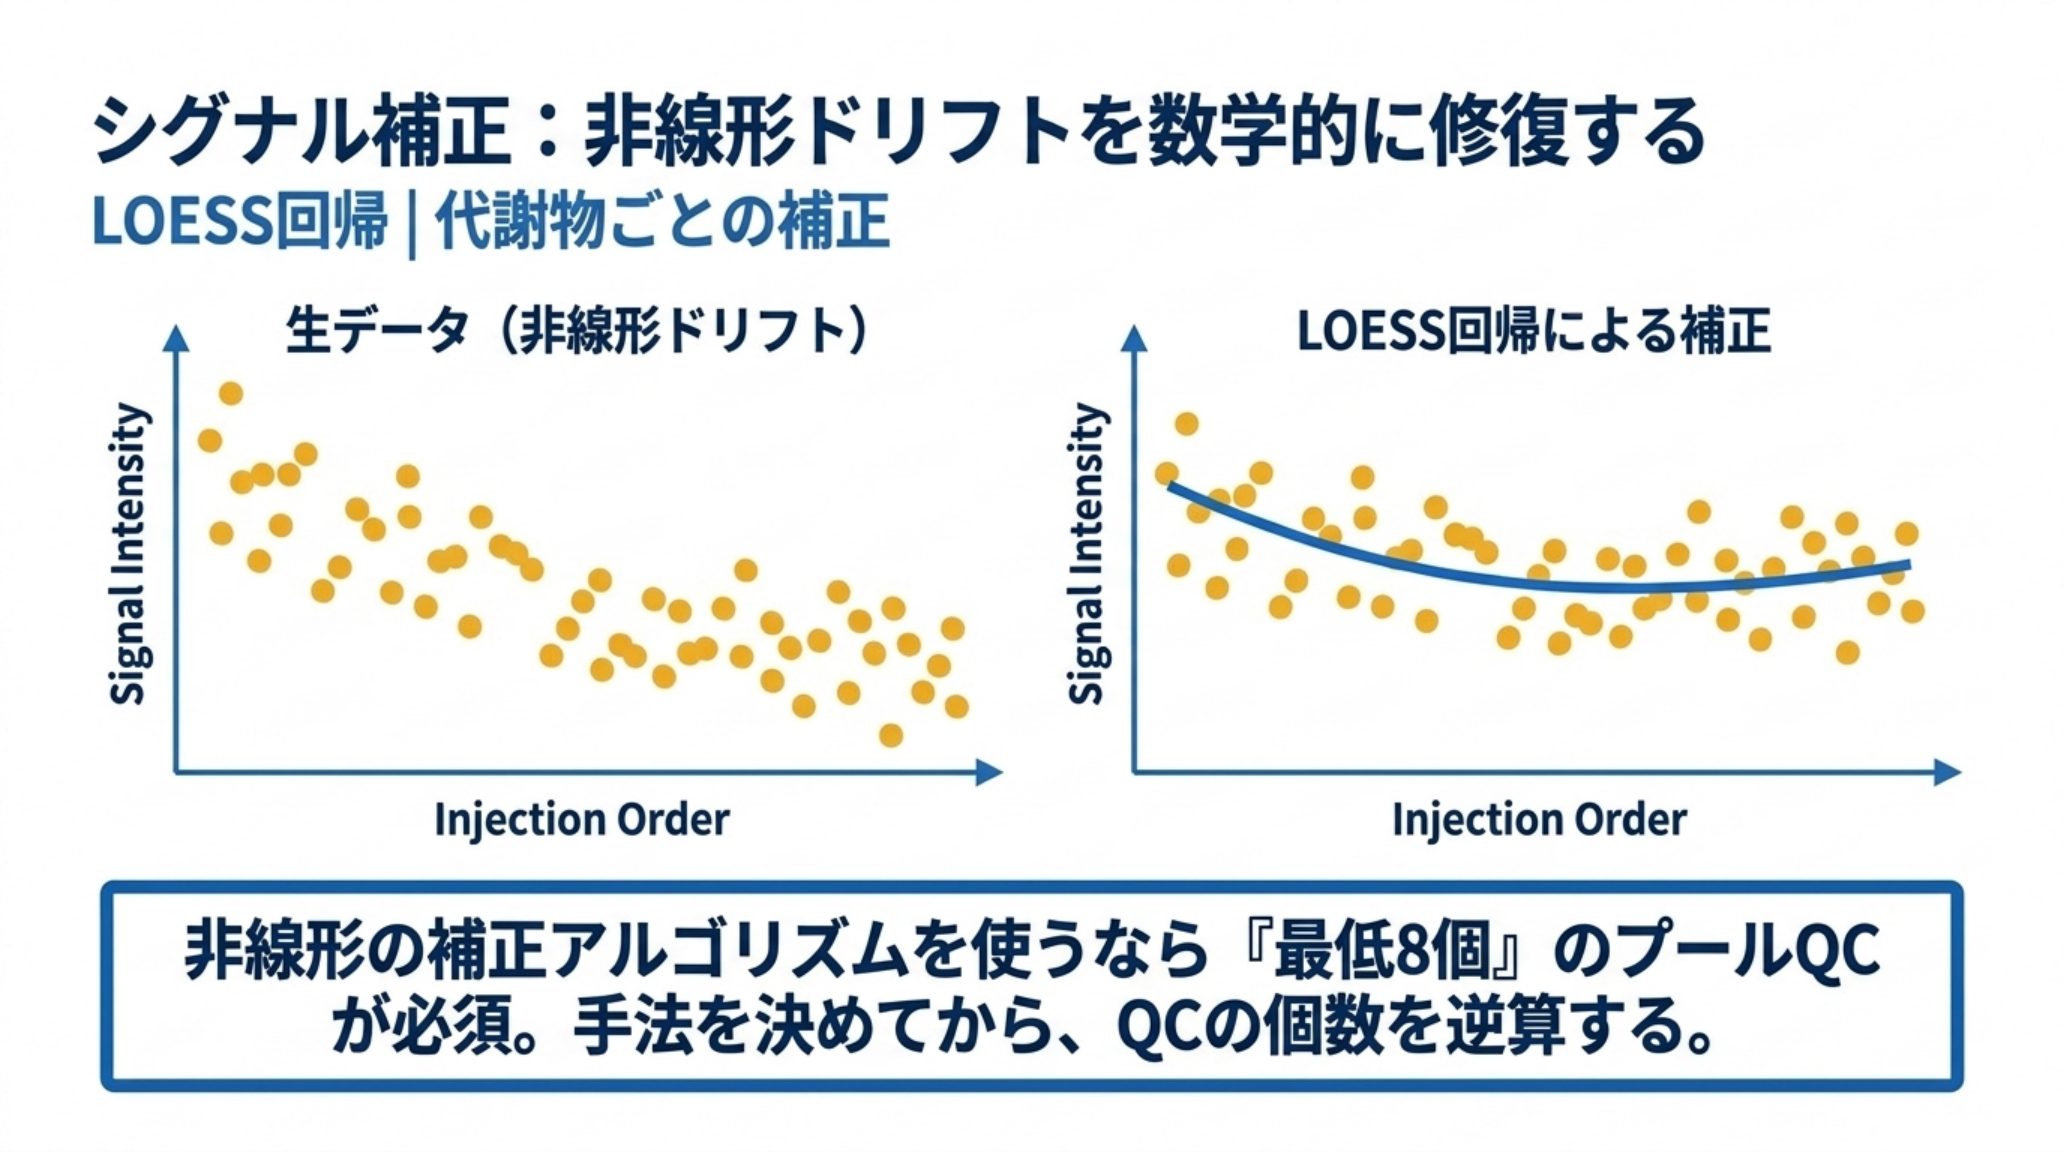
系統誤差(ドリフト)の扱いも避けて通れません。ガイドラインの記述は率直です。
系統誤差はほとんどすべてのノンターゲットのデータセットで観測される。変化の方向と非線形性の程度は代謝物に依存する。ドリフトがほとんど無い代謝物もあれば、時間とともに応答が有意に直線的に増加する代謝物、直線的に減少する代謝物、そして多くは非線形に変化する。
代謝物ごとにドリフトの向きが違う――だから単一の内標準で全体を割る、という補正は成立しません。プールQC を足場にして、特徴量ごとに補正曲線を当てることになります。
手法は複数あり、ガイドラインは並べたうえでこう結論しています。
線形回帰、区分的局所線形回帰、LOESS 回帰、正則化3次スプライン回帰、サポートベクター回帰、クラスタベース回帰などの方法がある。すべてに理論上の利点と欠点があり、単一の方法が明らかに優れているわけではない。
ここで 6 節の数値が効いてきます。非線形の補正アルゴリズムを使うなら最低 8 個のプールQC という勧告は、曲線を当てるための最小限の点数です。5 点では非線形の当てはめが不安定になります。補正手法を先に決めてから、QC の個数を決める――順序はこちらが正しい。
9. 実態 ― 109 報を数えたらどうだったか
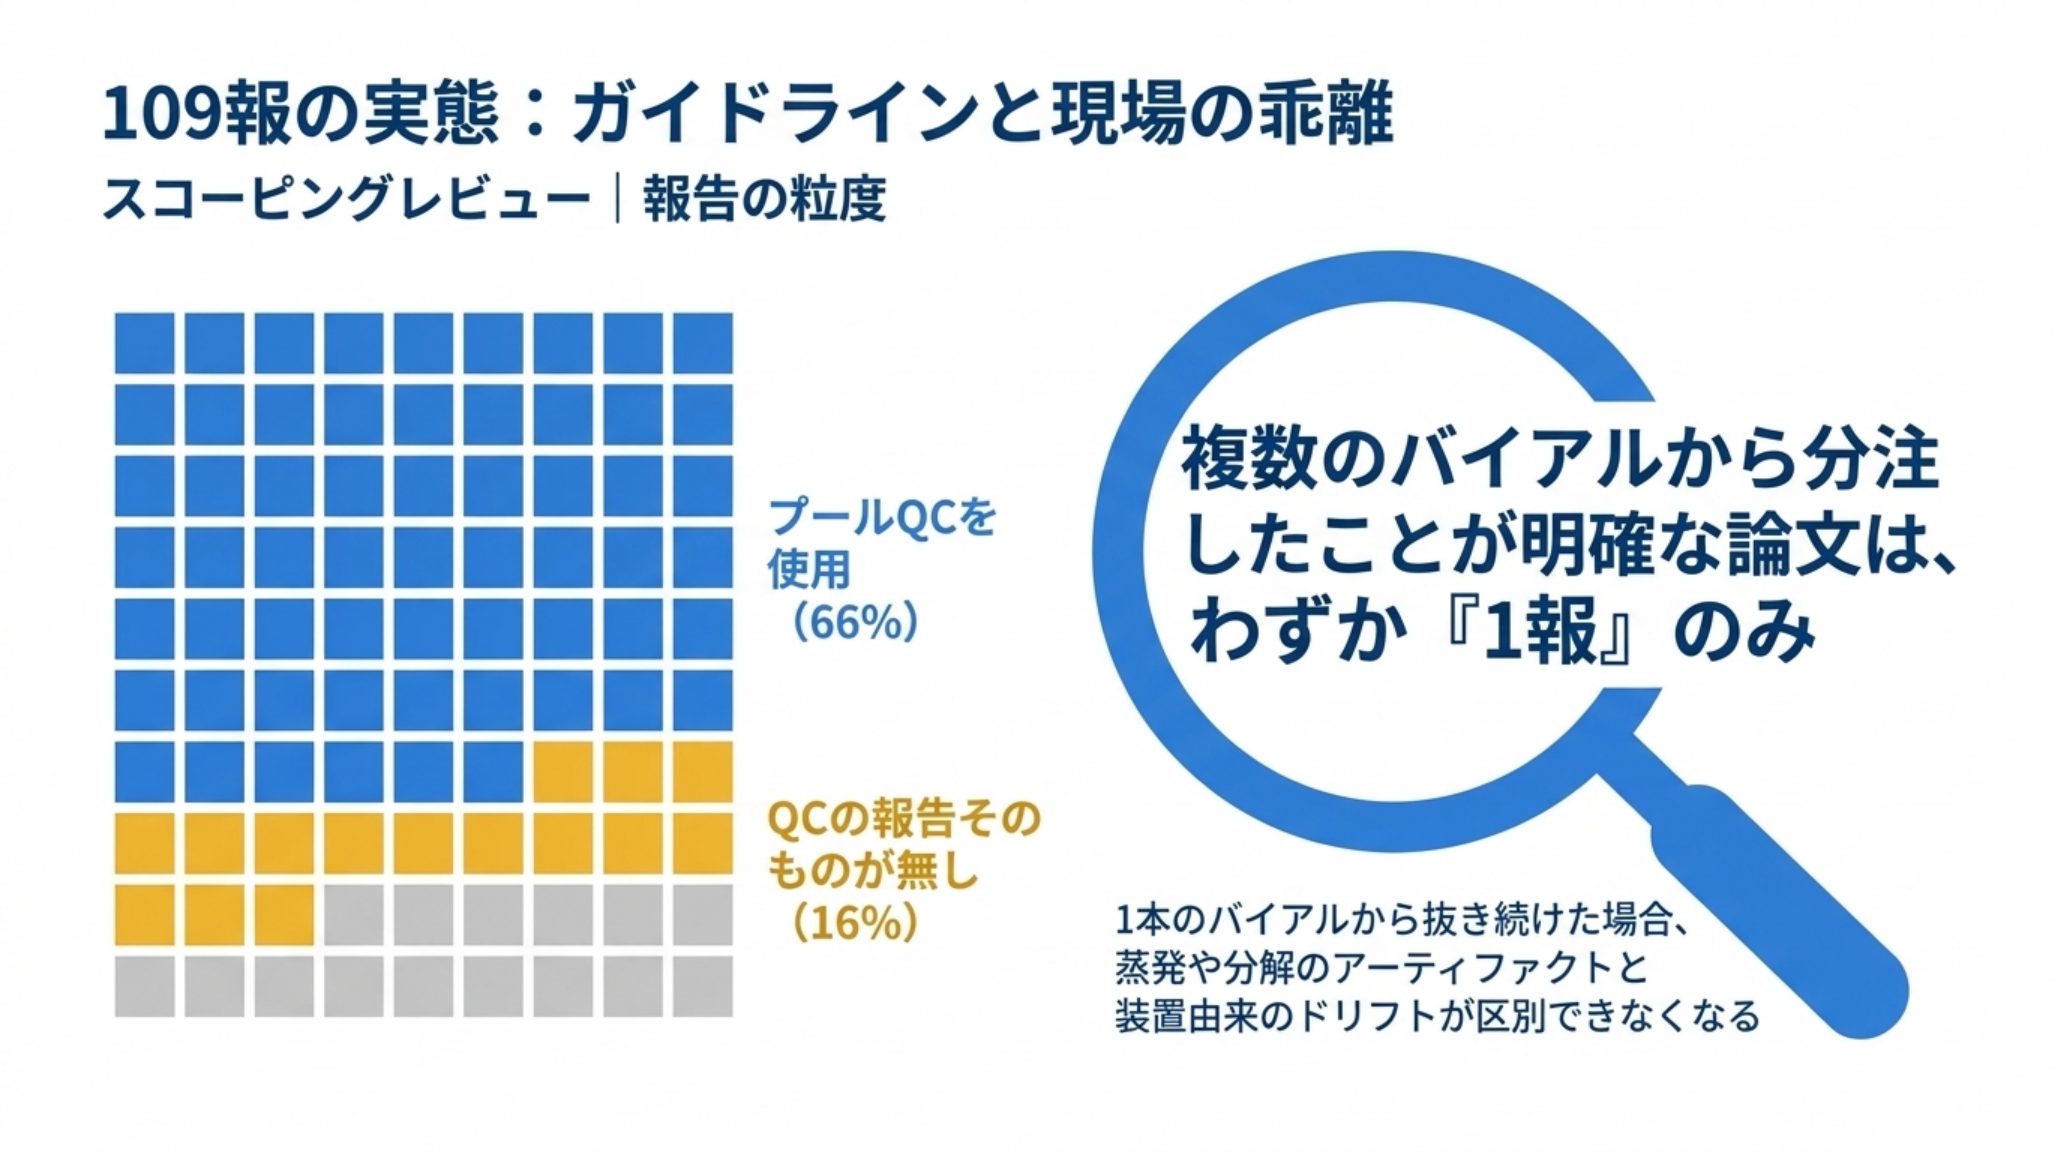
以上は「あるべき姿」です。では実際の論文はどうなっているか。2023 年に Analytical Chemistry に報告されたスコーピングレビューが、LC-MS ノンターゲットメタボロミクスの論文を数えています。
調査した 109 報のうち、72 報がプールQC 試料を研究で使用したと報告し、31 報はプールQC を使用せず、6 報は判断が分かれた。
プールQC を使っているのは約 66 %。3 分の 1 は使っていない、ということになります。さらに、
ここでレビューした 109 の研究のうち 17 報は、プールQC の使用も、その他の QC アプローチの使用も明確に報告していない。
注入頻度については、
最も多かった注入間隔は 6〜10 検体ごと(53 報中 29 報)であった。(次いで 2〜5 検体ごとが 10 報)
6 節で見たガイドラインの「少なくとも 10 検体ごと」とは整合しています。一方で、報告の粒度には問題が残っています。
プールQC のアプローチを報告した 72 報のうち…53 報のなかで、注入が複数のバイアルから行われたことが全てのレビュアーにとって明確だったのは、わずか 1 報だけであった。
プールQC を 1 本のバイアルから繰り返し注入しているのか、複数のバイアルに分注しているのかは、結果の解釈を変えます。 1 本から抜き続ければ、そのバイアル内での蒸発や分解の影響がドリフトとして見えてしまう。それが装置由来なのか試料由来なのかを区別できません。この区別が論文からほぼ読み取れないというのが、実態調査の結論でした。
10. 縮退を片づけても、まだ「何の分子か」は分からない
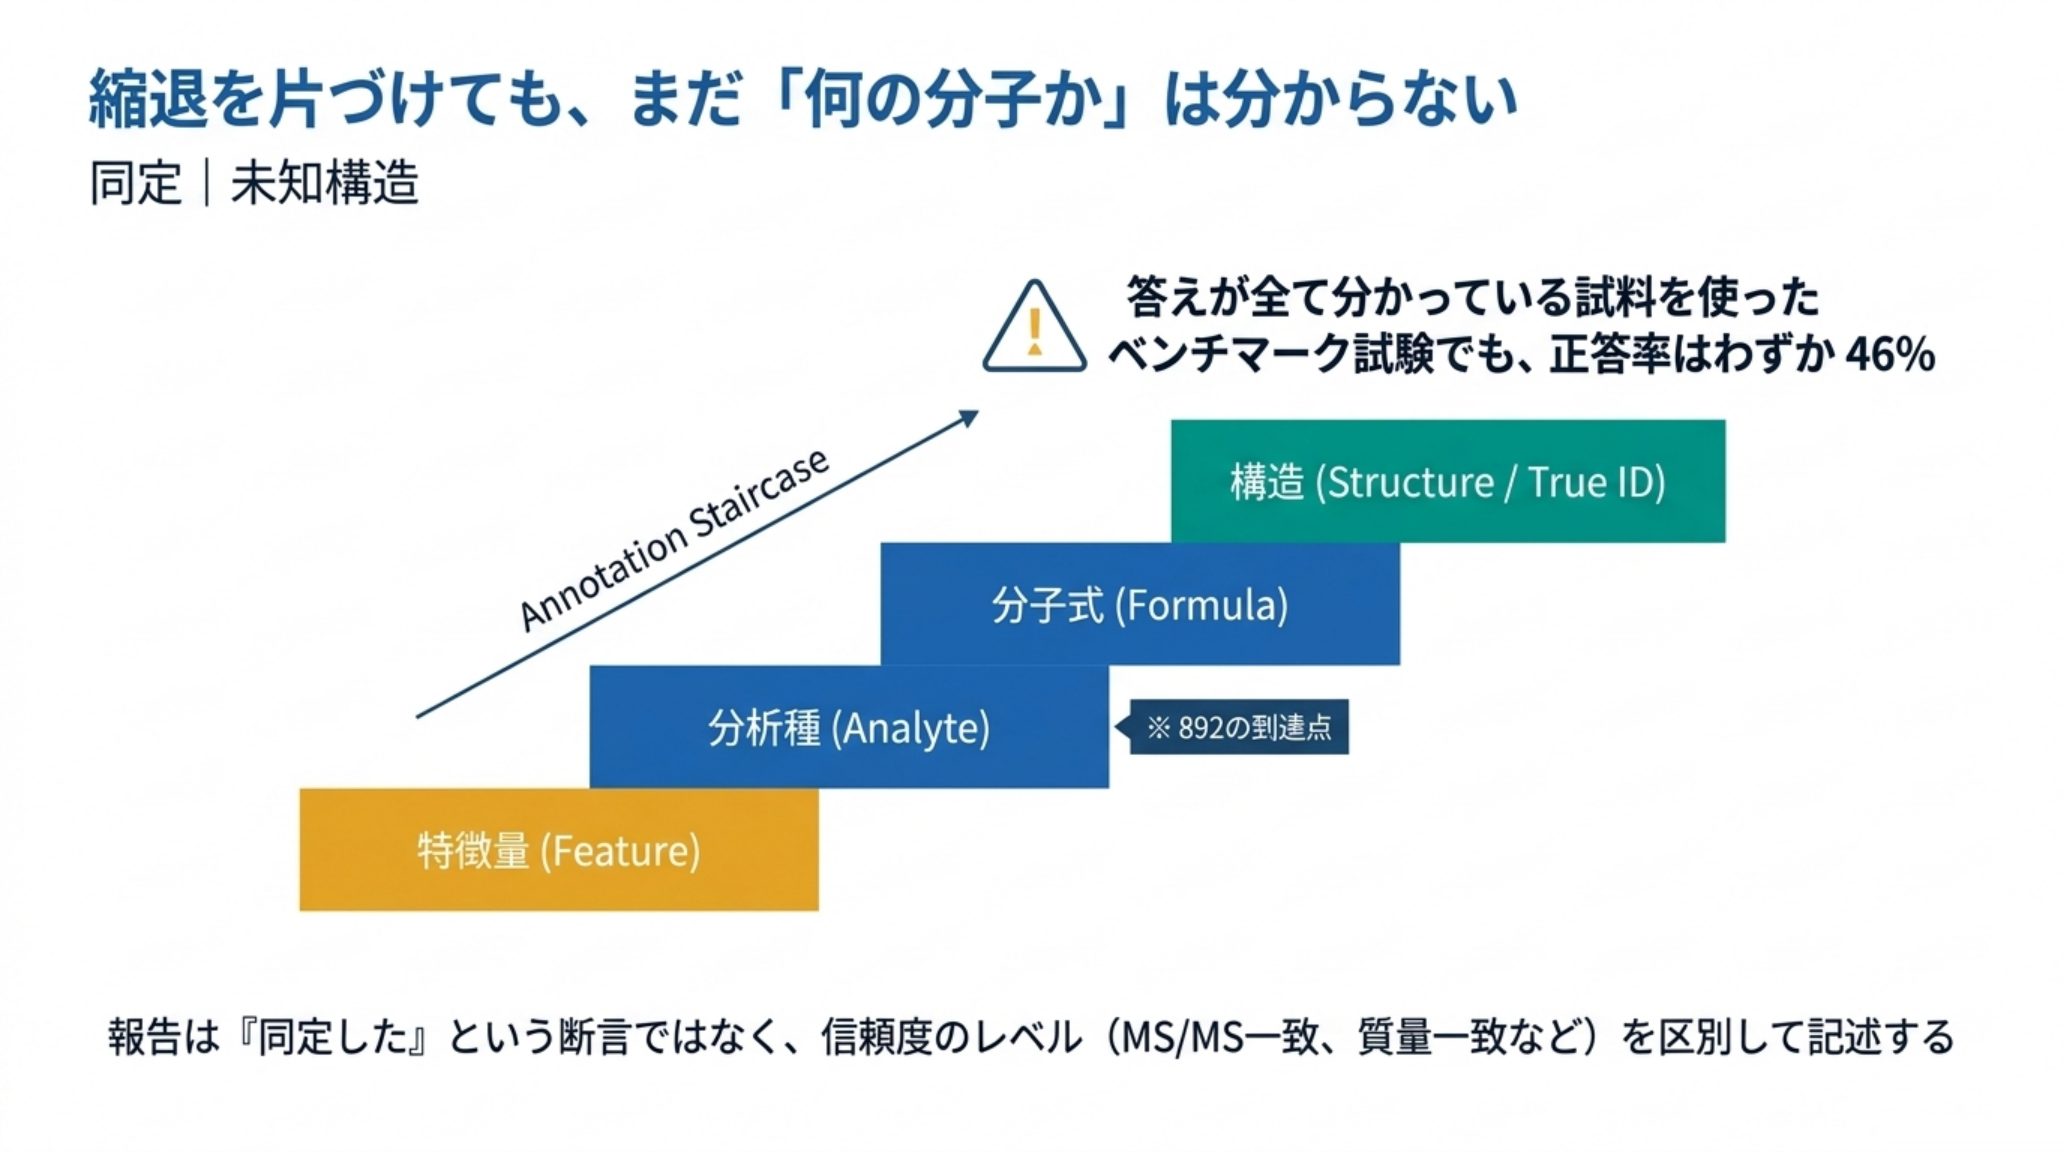
ここまでは数を正す話でした。892 の分析種まで絞り込んでも、それぞれが何という化合物かは別問題です。
ノンターゲット分析における同定の難しさ――精密質量から分子式が一意に決まらないこと、分子式が決まっても構造が決まらないこと、ベンチマーク試験で正答率が伸びないこと――は、非標的分析と未知構造推定で詳しく扱っています。答えが全部わかっている試料を使ったベンチマークでも、当てられたのは 46 % でした。
実務上の帰結は 2 つです。
- 報告は「同定した」ではなく信頼度の段階で書く。 標準品と保持時間・MS/MS まで一致したものと、精密質量がデータベースに合っただけのものは、別の記号で区別して報告します。
- 縮退の注釈と同定は順序がある。 先に縮退をまとめ、代表イオンを決めてから同定に進む。個々のアダクトやフラグメントを別々に同定しようとすると、同じ分子に別の名前が付きます。
11. 分析者の視点 ― 設計と報告で決まること
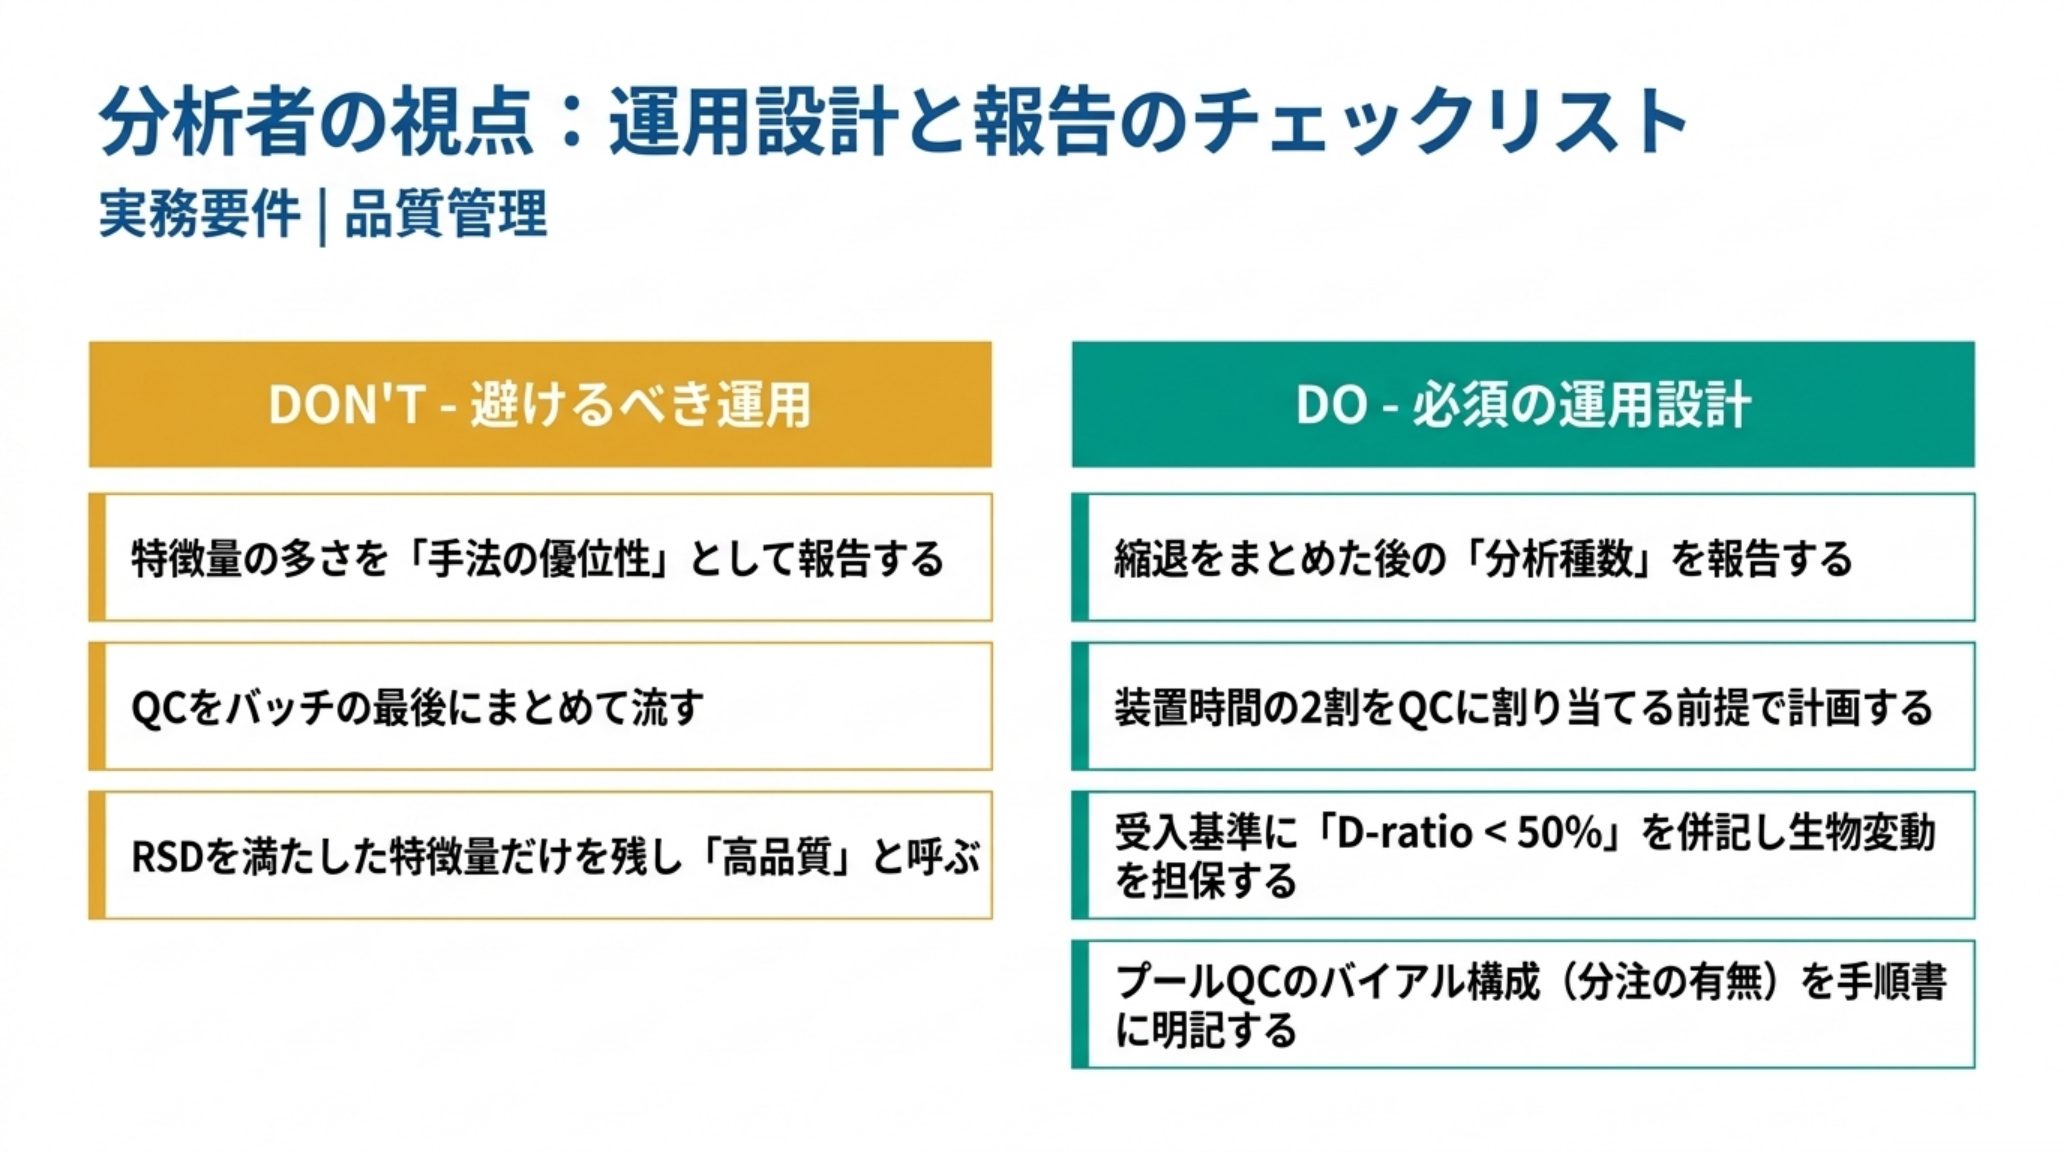
特徴量の数を成果として報告しない。 「25,000 の特徴量を検出」は、装置が正常に動いたことの証明にはなっても、測定できた代謝物の数ではありません。報告すべきは、縮退をまとめた後の分析種数と、同定の信頼度別の内訳です。
ブランクを必ず流し、必ず引く。 原著の実データでは、ブランク比較だけで特徴量の 49.3 % が消えました。抽出ブランク(試料なしで同じ前処理を通したもの)と溶媒ブランクは別物なので、両方を計画に入れます。
縮退の注釈を解析パイプラインに組み込む。 手作業では追えません。同位体・アダクト・中性ロス・多量体のグルーピングは、解析ソフトの機能として実装されています(CAMERA、MS-DIAL、mzMatch など)。使っていないなら、それは「25,000 個の独立した代謝物がある」という前提で統計をかけていることになります。
QC は装置時間の 2 割を占める前提で計画する。 100 検体なら QC は 22 注入前後(6 節)。この時間を削るなら、補正手法も受入基準も変えなければ筋が通りません。
受入基準は RSD と D-ratio の両方で書く。 RSD < 30 % だけでは、生物変動の小さい代謝物を拾えません。D-ratio < 50 %(できれば 30 % 以下) を併記すれば、「技術ノイズしか見ていない特徴量」を落とせます(7 節)。
プールQC のバイアル構成を手順書に書く。 1 本から繰り返し抜くのか、分注するのか。実態調査では 53 報中 1 報しか明確でなかった項目です(9 節)。自分の手順書には書けるはずです。
よくある落とし穴を挙げます。
- 特徴量数の多さを手法の優位性として比較する。 縮退の注釈をしていない側のほうが数字は大きくなります。比較するなら、同じ注釈パイプラインを通したあとで。
- PCA のローディング上位を「重要な代謝物」として列挙する。 同じ分子のアダクト違いが並んでいる可能性があります。
- QC をバッチの最後にまとめて流す。 ドリフトの形が取れないので補正に使えません。均等配置が前提です(6 節)。
- コンディショニングの注入をデータに含めてしまう。 ガイドラインは「処理の前に除去する」と明記しています。
- 1 バッチに収まらない規模の研究で、バッチ間の補正を設計していない。 長期参照QC や標準物質が必要になります(5 節の表)。
- RSD を満たした特徴量だけを残して「高品質なデータセット」と呼ぶ。 生物変動の大きい代謝物ほど RSD も大きくなりがちで、情報量の多い特徴量から落としているかもしれません。
まとめ
- 特徴量は代謝物ではない。 大腸菌の実データで、25,230 の特徴量は最終的に 892 のユニークな分析種になりました(28.3 分の 1)。内訳はブランク由来 49.3 %、同位体・アダクト・中性ロス・多量体・状況依存アダクトによる縮退、そして credentialing で落ちる非生物由来シグナルです。代謝物 1 つが 100 本のピークを生んだ例も報告されています。
- 縮退は統計の検出力を削る。 Bonferroni のしきい値は、25,230 で補正すると 892 で補正する場合より 28.3 倍厳しくなります(筆者計算)。縮退した特徴量どうしは強く相関するため、FDR 補正の前提も崩れ、多変量解析では高濃度成分の寄与が水増しされます。縮退の注釈は統計の前処理です。
- プールQC は 3 つの役割を兼ねている。 コンディショニング・再現性測定・シグナル補正。ガイドラインの勧告は 10 検体ごとに 1 回以上、1 バッチに最低 5 個、非線形補正を使うなら 8 個以上、前後に 2 個ずつ、コンディショニング 8 個はデータから除去。100 検体なら QC が総注入の約 18 % を占めます(筆者計算)。
- 受入基準は 3 つ。 検出率 > 70 %、RSD < 20〜30 %(試料タイプによる)、D-ratio < 50 %(できればはるかに低く)。D-ratio < 50 % は「観測された分散の 75 % 以上が生物由来」という意味で、RSD 単独では判定できない部分を補います(筆者計算)。
- 補正手法に定番はない。 LOESS・スプライン・SVR など複数あり、ガイドライン自身が「単一の方法が明らかに優れているわけではない」と書いています。手法を先に決め、必要な QC 個数を逆算するのが順序です。
- 実態は追いついていない。 109 報の調査で、プールQC を使っていたのは 72 報(約 66 %)、17 報は QC の報告そのものが無し。注入頻度は 6〜10 検体ごとが最多(53 報中 29 報)でした。
未確認・限界
- 25,230 → 892 という数字は、大腸菌抽出物を 1 つのノンターゲット法(逆相 UPLC + Q Exactive Plus、ポジティブイオンモード)で測定した 1 つのデータセットの結果です。 試料の種類(血漿・尿・組織・植物)、カラム、イオン化モード、解析ソフトによって縮退の度合いは変わります。「常に 28 分の 1 になる」という一般則ではありません。
- 原著の各段階の数値は、注釈の順序と閾値の設定に依存します。 本記事の表は原著が報告した順に並べたもので、順序を変えれば各段階の数は変わります。また「頻出の内在的関係」の段階では、原著は複数の閾値での結果を示しています。本記事は最終的な到達点(約 2,961、および credentialing 後の 892)を軸に整理しました。
- credentialing は安定同位体標識した培養が可能な系にしか適用できません。 ヒト血漿・尿・組織などの臨床試料では、この手法で生物由来シグナルを選別することはできません。臨床メタボロミクスでは、ブランク比較と縮退の注釈までが現実的な手段になります。
- Bonferroni 補正の比較は、検定数だけを変えた単純な計算です。 実際の解析では FDR 補正が使われることが多く、また特徴量間の相関構造によって実効的な検定数はさらに変わります。28.3 倍という数字は「分母の違いが検出力に効く規模」を示すもので、特定の研究での検出力の差を予測するものではありません。
- D-ratio と分散の関係(生物由来の割合 = 1 − D²)は、総分散 = 生物分散 + 技術分散という加法モデルを前提としています。 ガイドライン自身が、誤差が加法的か乗法的かは工程によること、正規分布でない場合は対数変換や非パラメトリックな代替が必要なことを述べています。対数変換が必要な系では、そのまま当てはめられません。
- 7 節の「RSD と D-ratio の対比表」は、関係を示すために筆者が値を置いた例です。 実測データではありません。
- QC が総注入の 18〜24 % という試算は、100 検体を 1 バッチで回し、ガイドラインの推奨をすべて満たした場合の計算です。 実際のバッチ長、MS/MS 取得の有無、標準物質やブランクの本数によって変わります。
- 前処理(クエンチング・抽出溶媒・タンパク除去)とカラム選択(逆相/HILIC の相補性)については、本記事では扱っていません。 縮退と品質管理に焦点を絞っています。
- 同定(アノテーション)の信頼度については本記事では深入りしていません。 非標的分析と未知構造推定を参照してください。
用語集
- 特徴量(feature):ノンターゲット解析ソフトが検出する「m/z と保持時間の組」。化学的な正体は問わない。
- 縮退(degeneracy):同じ分析種が複数の特徴量として検出されること。同位体・アダクト・中性ロス・多量体・インソースフラグメントが原因。
- アダクト(付加イオン):分子に H⁺・Na⁺・K⁺・NH₄⁺ などが付いたイオン。同じ分子が別の m/z に現れる。
- インソースフラグメント:イオン源内で分子が開裂した断片イオン。質量的には別の代謝物に見えるため、縮退のなかで最も厄介。
- credentialing:¹²C と ¹³C の培養を混ぜて測り、同位体パターンから生物由来のシグナルだけを選別する手法。培養できる系に限られる。
- プールQC(pooled QC):研究中の全検体から少量ずつ取って混ぜた試料。バッチ内に繰り返し挟み、コンディショニング・再現性測定・シグナル補正に使う。
- 検出率(detection rate):その特徴量が全検体中の何 % で検出されたか。受入基準は典型的に > 70 %。
- RSD(相対標準偏差):プールQC における標準偏差 ÷ 平均。技術的なばらつきの指標。典型的な受入基準は < 20 % または < 30 %。
- RSD*:中央絶対偏差(MAD)を用いた頑健版の RSD。1.4826 × MAD ÷ 中央値。
- D-ratio(分散比):プールQC の標準偏差 ÷ 生物試料の標準偏差。技術ノイズが生物変動に対してどれだけ大きいかを表す。受入基準は < 50 %。
- コンディショニング:バッチ開始時にプールQC を繰り返し注入して装置を安定させる操作。そのデータは解析前に除去する。
- システム適合性試料:試料分析の前に、装置の動作と汚染の有無を確認するための試料。
- LOESS:局所回帰による平滑化。シグナルドリフトの非線形補正に使われる代表的な手法のひとつ。
関連記事
- 非標的分析と未知構造推定 ― 答えが全部わかっている試料でも、当てられたのは46%だった【2026年版】 ― 10 節の続き。縮退をまとめた後に残る「では何の分子か」の問題を、ベンチマーク試験の実測値で扱っています。
- NMRメタボロミクス ― ビン幅を 4 倍にしただけで、第 1 主成分が「磁場強度」から「品種」に入れ替わった【2026年版】 ― 同じメタボロミクスを NMR で行う側。感度では MS に 10〜100 倍負けるのに大規模コホートが NMR で測られる理由も。
- プロテオミクスのDDA/DIA ― タンパク質の「FDR 1%」が妥当だと確かめられた組み合わせは、24件中ゼロだった【2026年版】 ― 隣接するオミクスでの多重検定と FDR の扱い。4 節と同じ構造の問題です。
- HILIC徹底解説 ― 逆相で保持しない極性化合物を、水層と平衡化から攻略する【2026年版】 ― 極性代謝物のカバー範囲を広げる側。逆相と組み合わせる運用が一般的です。
- マトリックス効果とイオン化抑制の対処 ― 犯人はリン脂質だけではないし、動くし、重水素標識の内標準にも穴がある ― プールQC で補正しようとしている系統誤差の、イオン源側の正体。
- イオン源の選び方 ― 専用ESIと専用APCIは「別の89%」を拾う【2026年版】 ― 2 節で見た縮退(アダクト・インソースフラグメント)を生んでいる装置側の仕組み。
- 定量LC-MS/MSのメソッド開発 ― MRM最適化に「最大化してよい量」はひとつもない【2026年版】 ― 標的定量に移したあとの世界。ノンターゲットとの役割分担の参考に。
- 標準物質・検量線・トレーサビリティ ― 相関係数 0.999 を満たした検量線の 95 % で、定量下限が ±20 % を外れていた【2026年版】 ― 5 節の表にある標準物質(SRM)の位置づけ。
- ケモメトリクス入門 ― 乱数だけの表に PCA をかけても、主成分が 49 本「見つかる」【2026年版】 ― 4 節で触れた多変量解析の落とし穴。縮退した特徴量を入れたまま PCA をかけるとどうなるか。
- AI・機械学習が変える分析化学 ― 正解率 69.6 % は、15 個の候補のどれかが当たった割合である【2026年版】 ― メタボロミクスのデータ解析に機械学習を持ち込むときの前提。
出典
- N.G. Mahieu, G.J. Patti「Systems-Level Annotation of a Metabolomics Data Set Reduces 25 000 Features to Fewer than 1000 Unique Metabolites」Analytical Chemistry 89(19), 10397–10406 (2017) DOI: 10.1021/acs.analchem.7b02380(本記事 1〜4 節の数値はすべてこの論文の報告値) — https://pmc.ncbi.nlm.nih.gov/articles/PMC6427824/
- D. Broadhurst, R. Goodacre, S.N. Reinke, J. Kuligowski, I.D. Wilson, M.R. Lewis, W.B. Dunn「Guidelines and considerations for the use of system suitability and quality control samples in mass spectrometry assays applied in untargeted clinical metabolomic studies」Metabolomics 14:72 (2018) DOI: 10.1007/s11306-018-1367-3(5〜8 節の勧告・受入基準・D-ratio の定義) — https://link.springer.com/article/10.1007/s11306-018-1367-3 / 全文PDF — http://biospec.net/pubs/pdfs/Broadhurst-Metabolomics2018.pdf
- 「Current Practices in LC-MS Untargeted Metabolomics: A Scoping Review on the Use of Pooled Quality Control Samples」Analytical Chemistry (2023) DOI: 10.1021/acs.analchem.3c02924(9 節の 109 報の実態調査) — https://pmc.ncbi.nlm.nih.gov/articles/PMC10753522/
- W.B. Dunn ら「Procedures for large-scale metabolic profiling of serum and plasma using gas chromatography and liquid chromatography coupled to mass spectrometry」Nature Protocols 6, 1060–1083 (2011)(プールQC を用いた大規模プロファイリングの原型。RSD < 20 % の出どころのひとつ) — http://www.biospec.net/pubs/pdfs/Dunn-NatProt2011.pdf
筆者計算として示したのは次の 4 つです。(1) 各段階が最初の 25,230 に占める割合と 28.3 分の 1 という縮約率、(2) 検定数を変えたときの Bonferroni しきい値(α=0.05)と期待偽陽性数、(3) D-ratio から「観測された分散のうち生物由来の割合=1 − D²」を導いた対応表と、RSD が同じでも D-ratio が変わる例、(4) ガイドラインの推奨どおりに組んだ場合の 100 検体バッチにおける QC 注入数と所要時間。いずれも前提と限界を「未確認・限界」に明記しています。
調査で集めたソースのうち、URL を持たず本文に引用マーカーが埋め込まれた合成文書は採用していません。本記事の数値は、上記 4 件の原著にあたって確認できたものだけで構成しています。